Speech enhancement
Spectrale analyse, PCA-gebaseerde feature-reductie en Bayesiaanse/Kalman-schatting versterken spraak bij lage SNR met behoud van natuurlijke klankkleur.
Speechlab Advanced Technology ontwikkelt geavanceerde spraakversterking en ruisonderdrukking voor embedded systemen. Van microfoon-array tot DSP: spraak blijft verstaanbaar in lawaaiige omgevingen.
Een technisch lab voor real-time audio-DSP en spraakverbetering, van wiskundig model tot werkend demo-board.
Signaalverwerking, statistische modellering en embedded engineering in één ontwikkeltraject.
MATLAB-simulatie, implementatie op DSP of MCU, en een prototype met microfoon-array, codec en lage latentie.
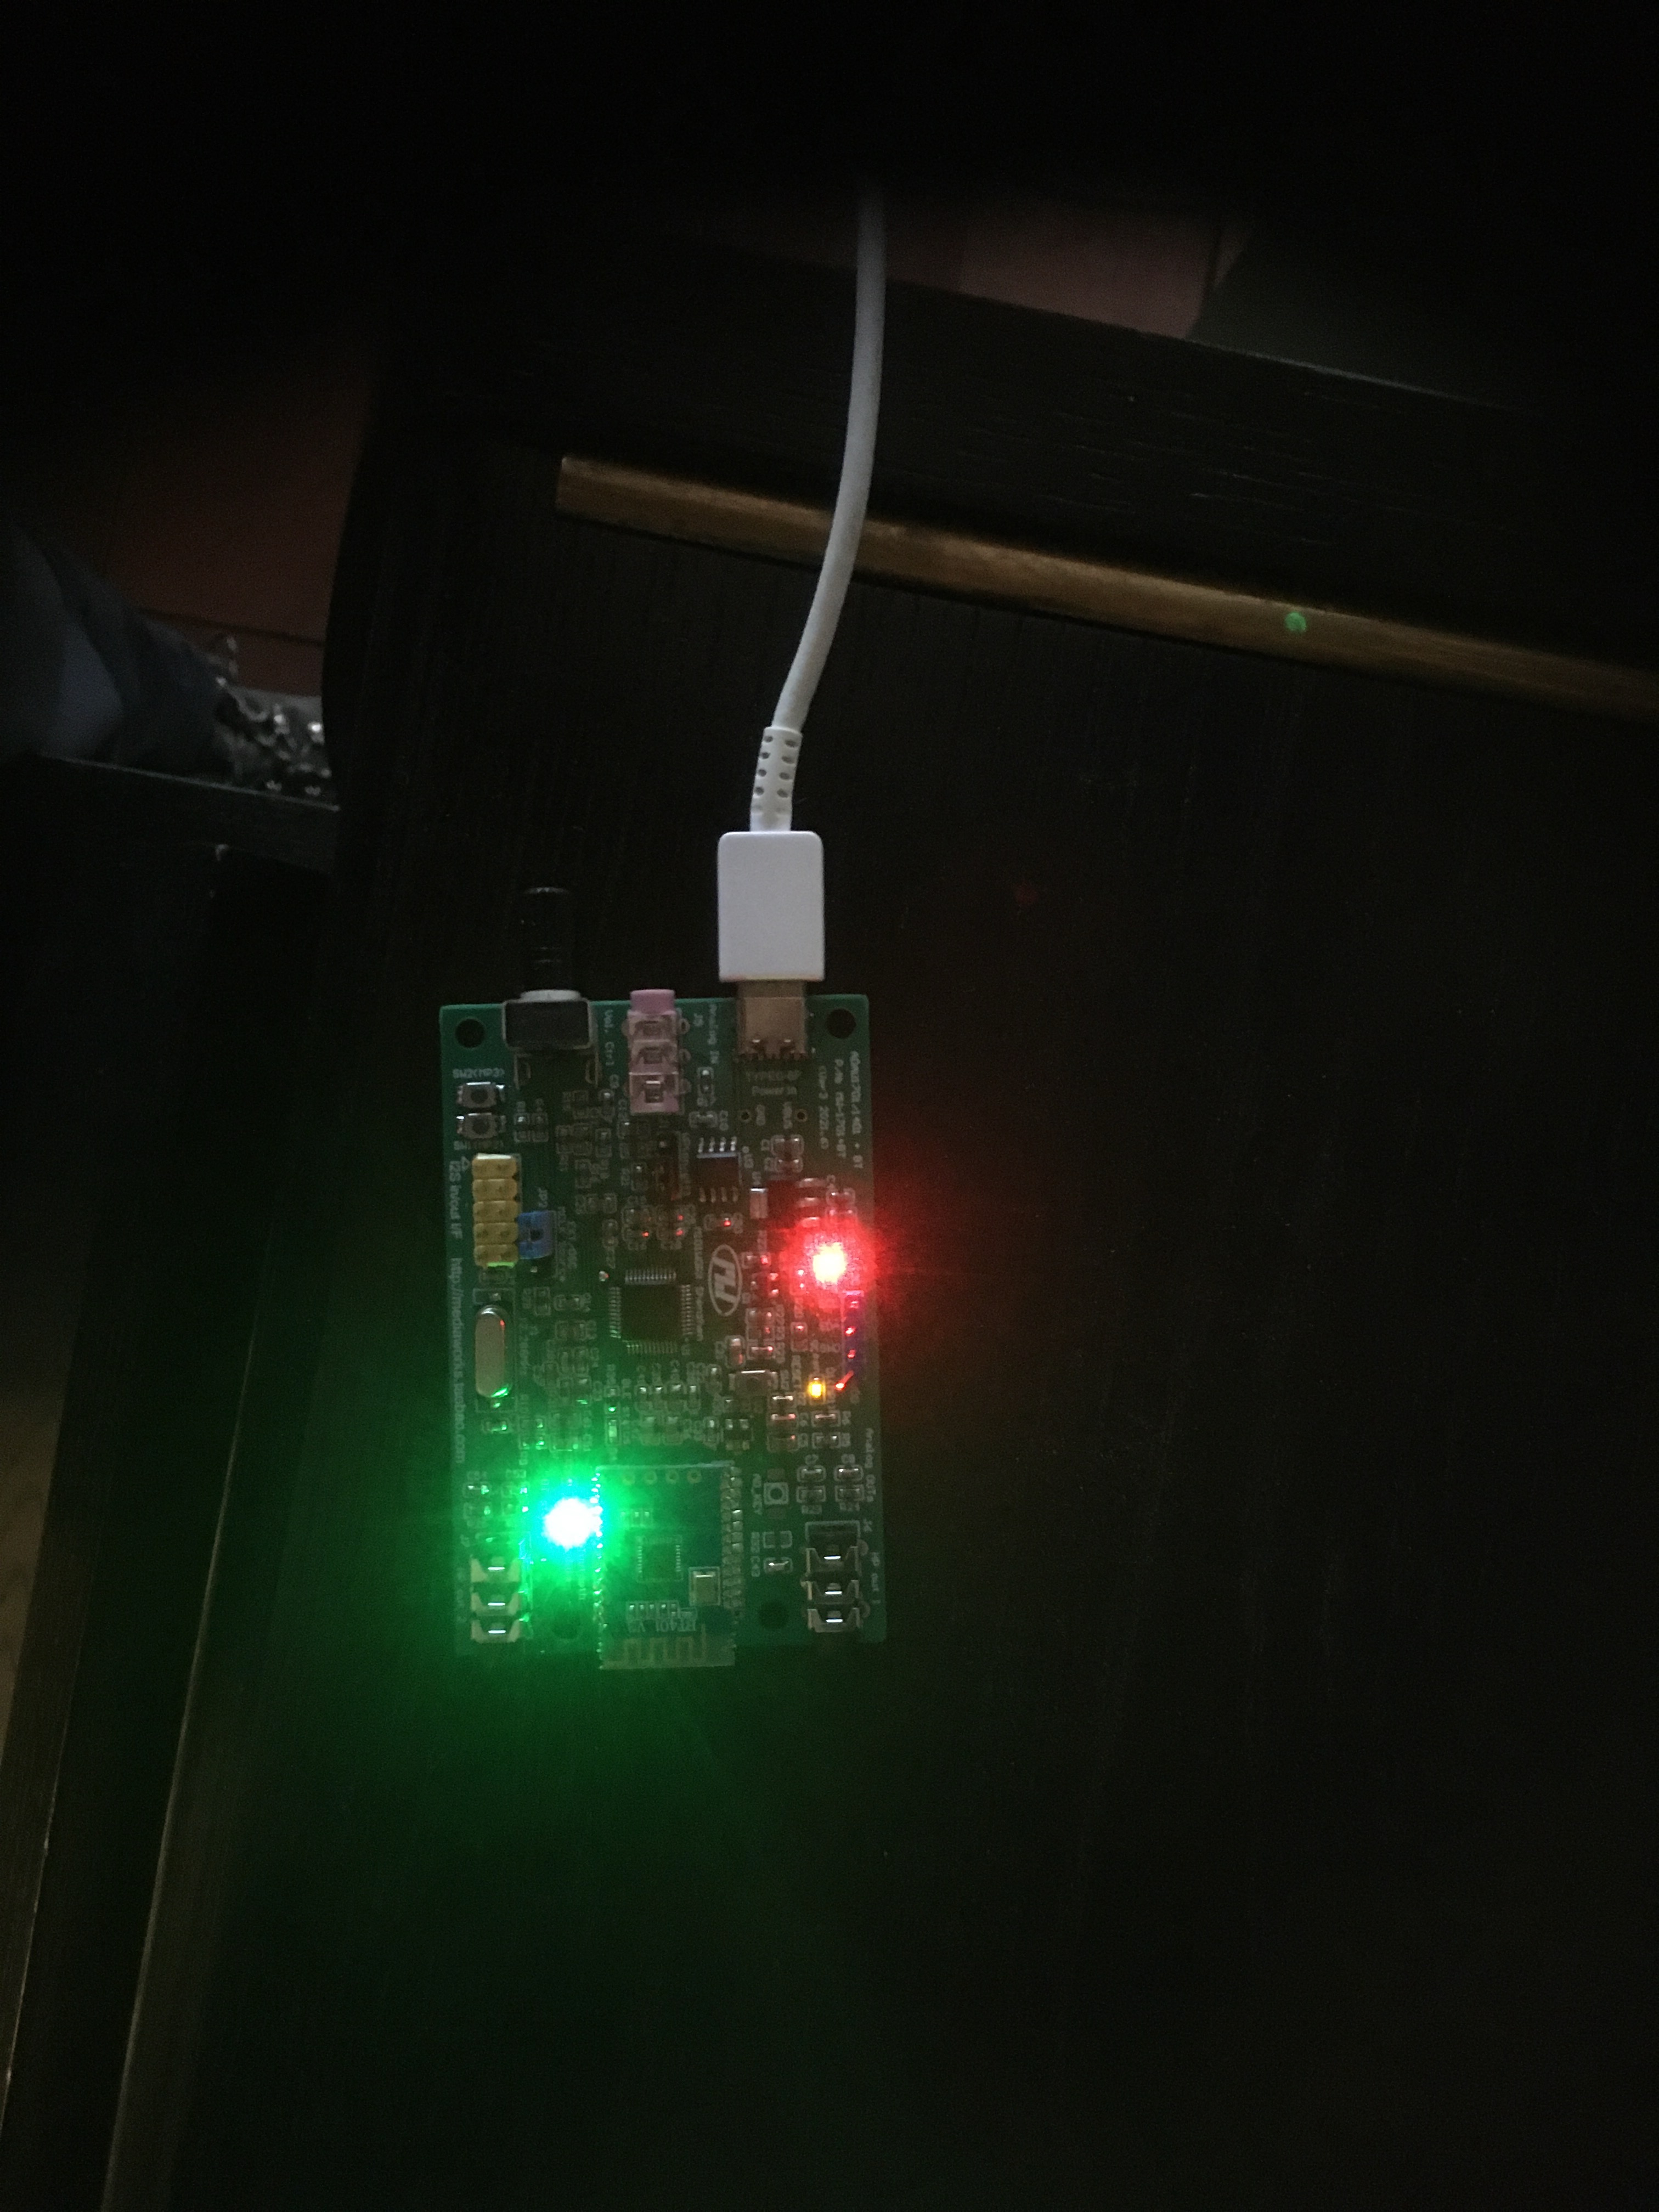
Spectrale analyse, PCA-gebaseerde feature-reductie en Bayesiaanse/Kalman-schatting versterken spraak bij lage SNR met behoud van natuurlijke klankkleur.
Robuuste F0-tracking en formantanalyse van F1–F3, ook in ruis, voor spraaktherapie, zangtechnologie en spraakcodering.
Ontwerp en integratie van 2–8 kanaals arrays met digitale beamforming, AEC en dereverb voor far-field spraak.
SHARC en Analog Devices DSP's, STM32, NXP i.MX RT en ARM Cortex-A/RISC-V edge devices met I²S/TDM en USB Audio.
MATLAB voor algoritme-ontwikkeling en haalbaarheidsanalyse, plus SDK-integratie en evaluatie met audio, spectrogrammen en visualisaties.
25–30 dB ruisreductie, ERLE boven 40 dB en minder dan 16 ms latency voor real-time interactie.
Heldere spraak in kantoren, thuiswerkplekken en hybride meetings, met multi-speaker ondersteuning, echo-cancellation en ruisonderdrukking.
Far-field spraak voor assistenten, kiosks, ATMs, drive-thru en robots, met betrouwbare trigger-phrase detectie en NLP-voorverwerking.
Spraakbediening en handsfree bellen met sterke onderdrukking van motor-, weg- en windruis.
Pitch- en formantvisualisatie voor documentatie en therapie, met referentiebanden voor stem en vocale tract-resonantie.
Werkende prototypes voor subsidieaanvragen, patenten en haalbaarheidsstudies—van algoritme naar demo in weken.
OEM's, startups, productontwikkelaars en onderzoeksteams in conferencing, robotica, IoT, automotive en slimme terminals.
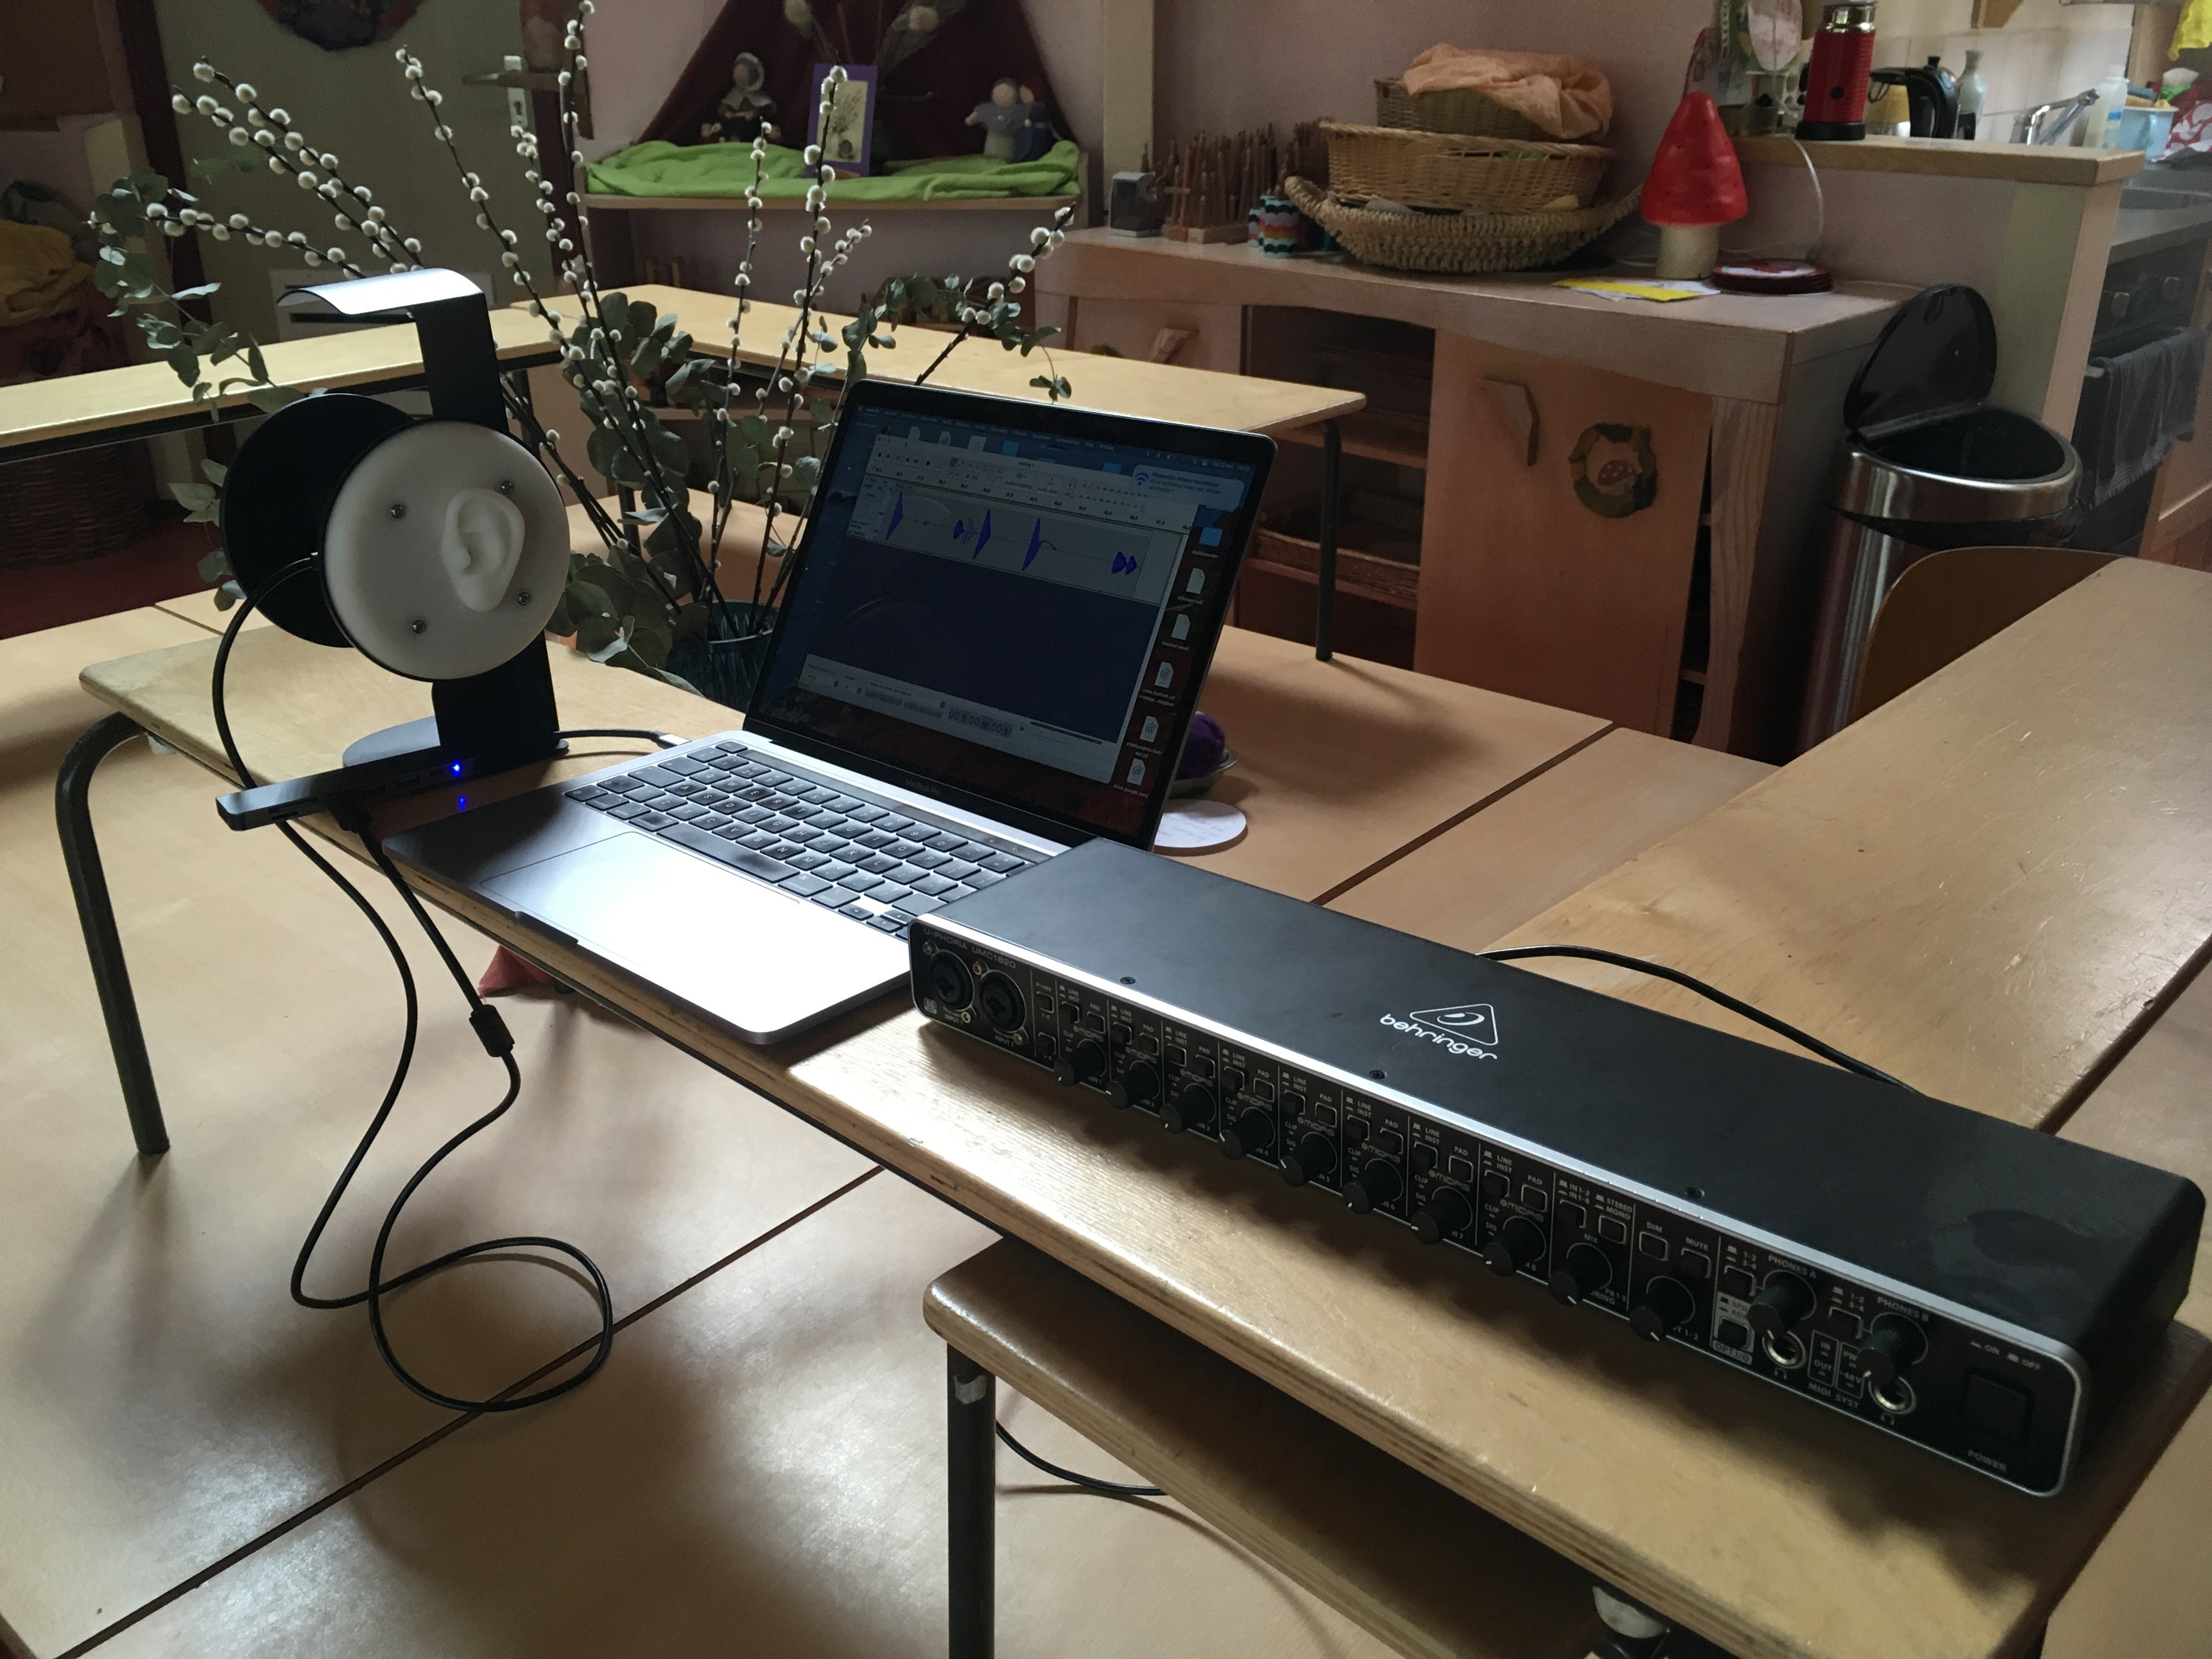
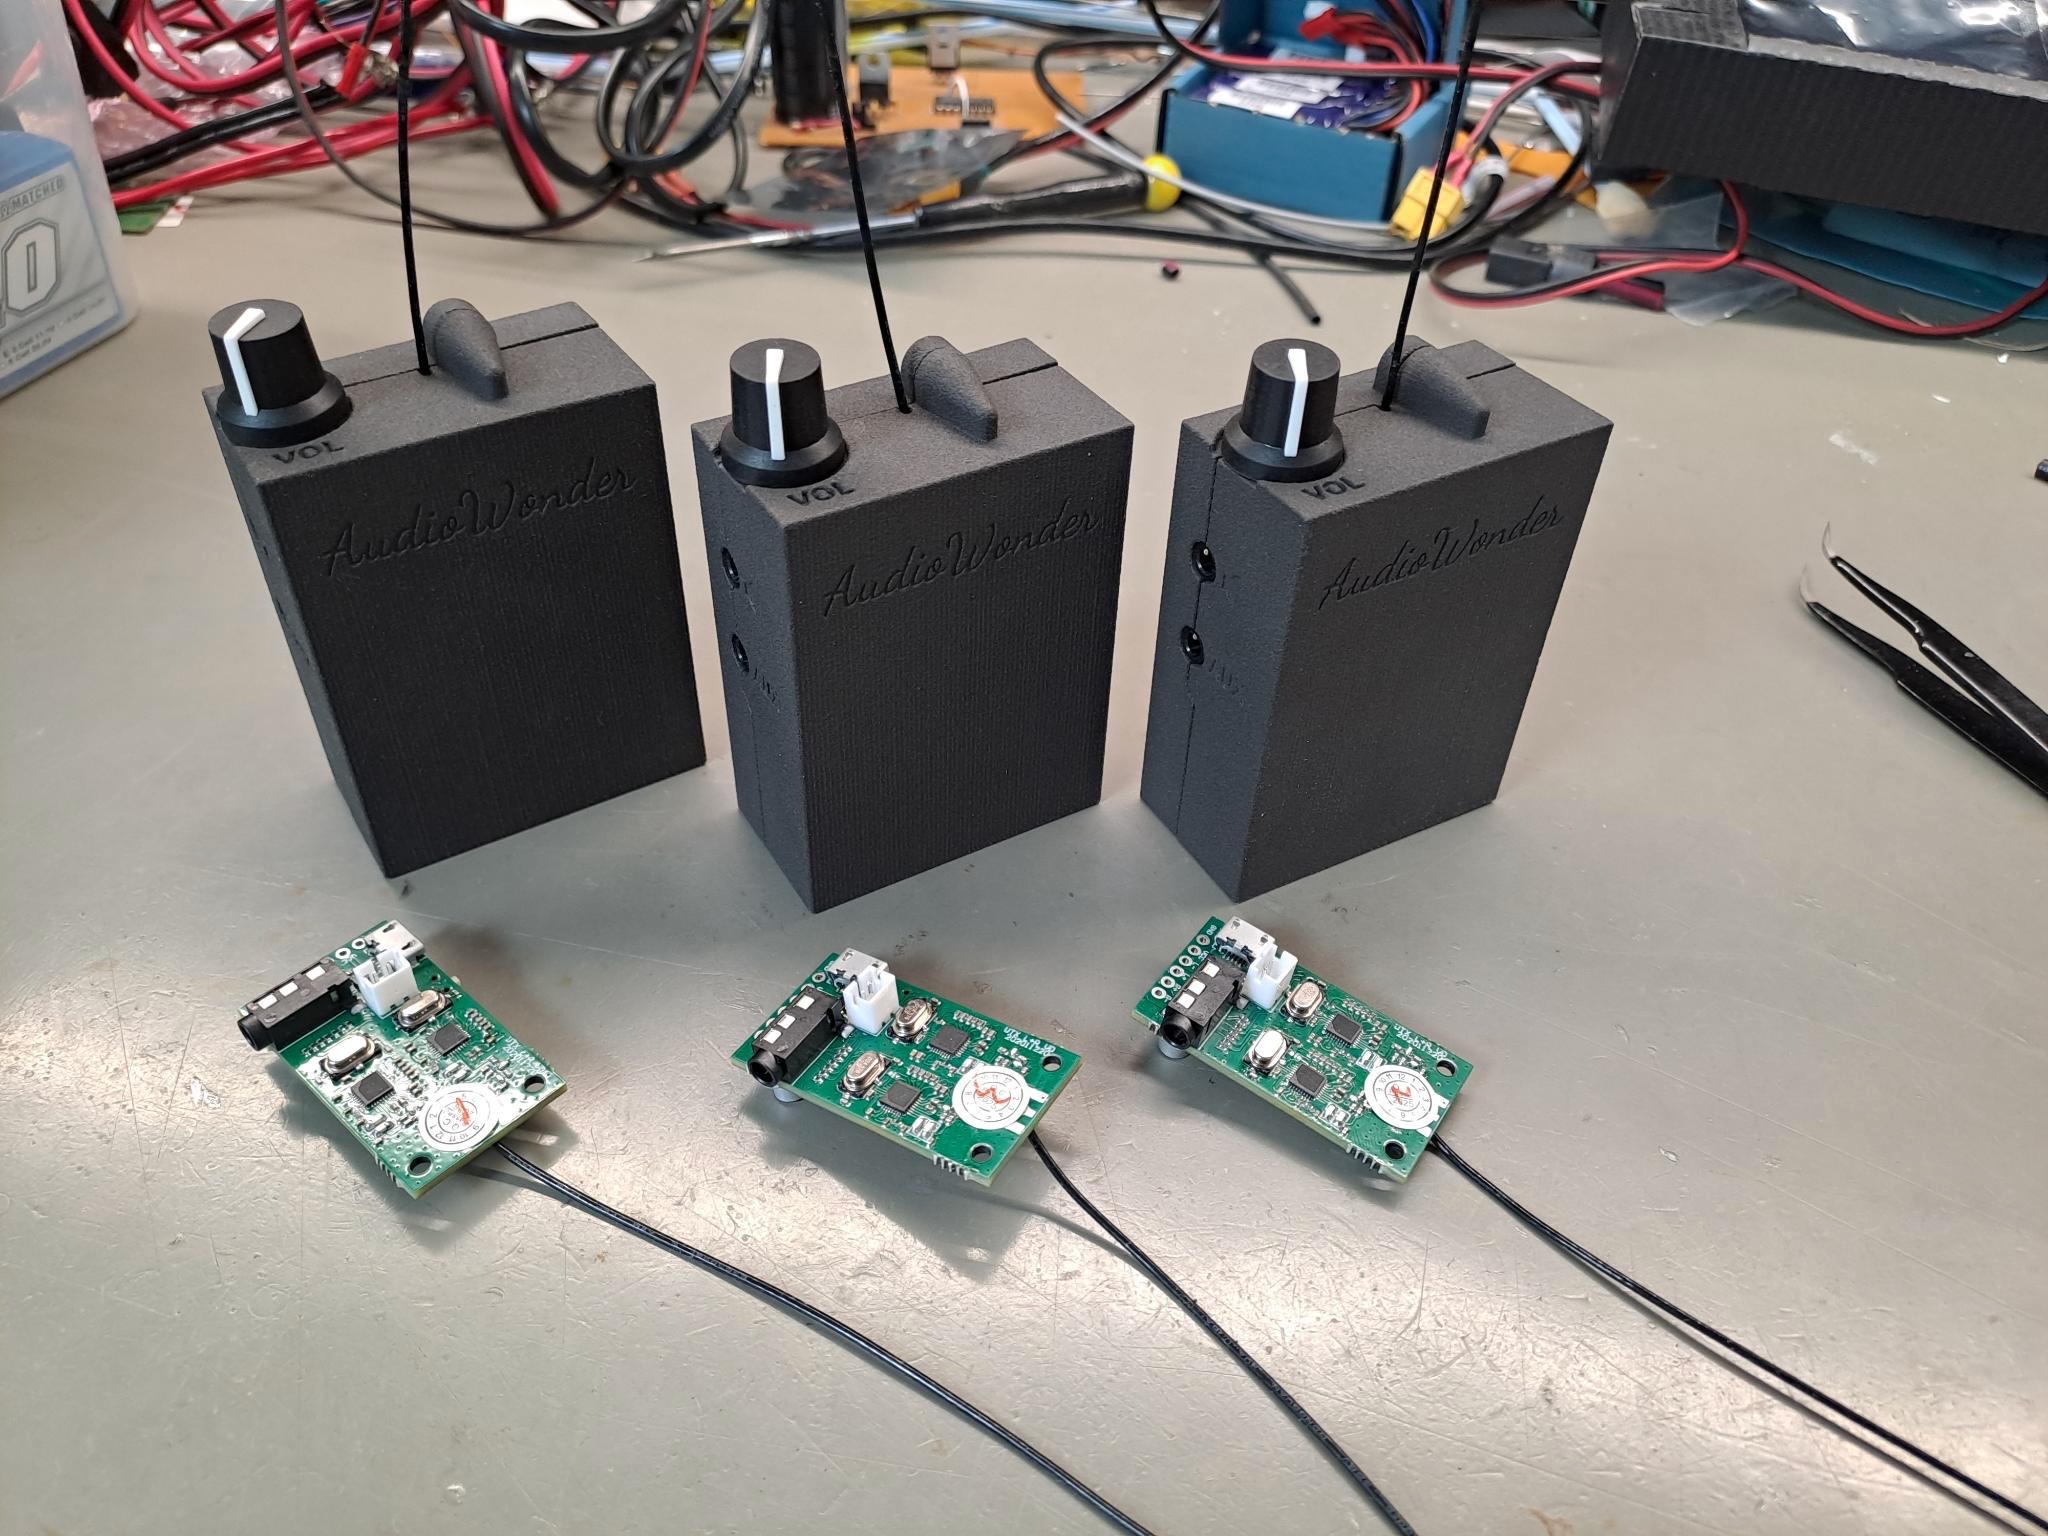
| Microfoons | 2–8 MEMS, omni of dipool, configureerbare array |
|---|---|
| DSP | SHARC / ADI audio-DSP of ARM Cortex-A / RISC-V edge-module |
| Algoritmen | NS, AEC, beamforming, dereverb en pitch-/formanttracking |
| Latentie | < 16 ms typisch voor interactieve toepassingen |
| Far-field | Tot circa 8 meter onder gunstige omstandigheden |
| Interface | USB Audio, I²S/TDM, optioneel Bluetooth/Auracast en NFC-configuratie |
| Formaat | Compacte modules rond 70 × 58 mm, 4–8 microfooningangen en laag stroomverbruik |
Project Audiowonder verzamelt informatie over obstakels die slechthorenden ervaren bij theater- of concertbezoek. Dit gaat onder meer via vragenlijsten en het organiseren van speciale concerten. Het doel is om voorzieningen te verbeteren, bewustwording te vergroten, actief bij te dragen aan evenementen, technische ontwikkelingen te initiëren en ondersteunen en informatie te geven aan slechthorenden, theaters en audiciens, en zo bij te dragen aan een toegankelijker cultuurbeleving voor slechthorenden.